逻辑回归
逻辑回归介绍
线性回归预测的是一个连续值, 逻辑回归给出的”是”和“否”的回答.
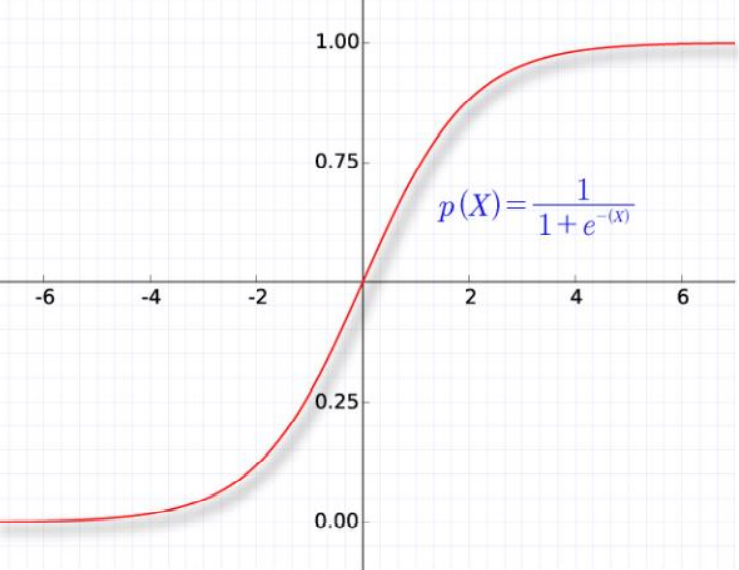
逻辑回归通过sigmoid函数把线性回归的结果规范到0到1之间.
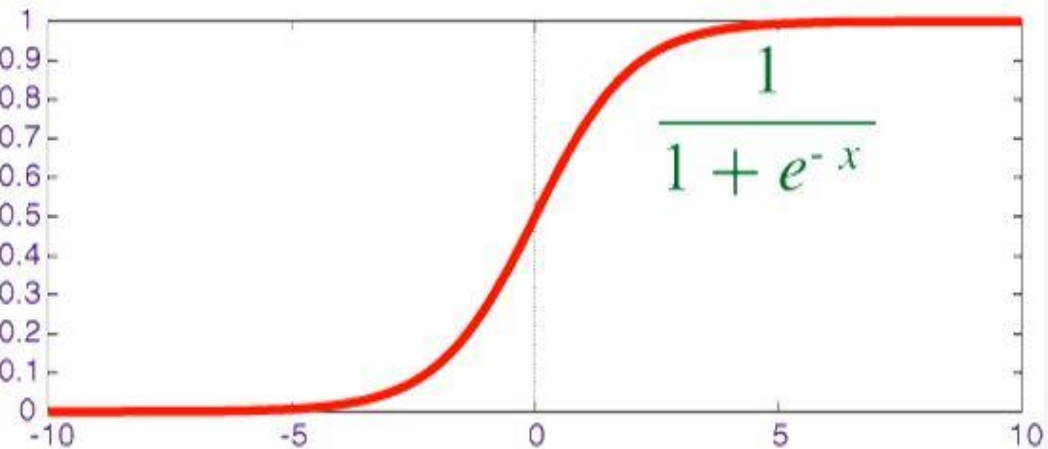
sigmoid函数是一个概率分布函数, 给定某个输入,它将输出为一个概率值.
逻辑回归损失函数
平方差所惩罚的是与损失为同一数量级的情形 对于分类问题,我们最好的使用交叉熵损失函数会更有效 交叉熵会输出一个更大的“损失”
交叉熵刻画的是实际输出(概率)与期望输出(概率)的距 离,也就是交叉熵的值越小,两个概率分布就越接近。假设 概率分布p为期望输出,概率分布q为实际输出,H(p,q)为交 叉熵,则
在pytorch里,我们使用 nn.BCELoss() 来计算二元交叉熵.
下面我们用一个实际的例子来实现pytorch中的逻辑回归
逻辑回归分类实例 信用卡反欺诈数据
import torch
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
from torch import nn

data = pd.read_csv('./dataset/credit-a.csv', header=None)

X = data.iloc[:, :-1]
Y = data.iloc[:, -1].replace(-1, 0)
# 转化为tensor并修改类型
X = torch.from_numpy(X.values).type(torch.FloatTensor)
Y = torch.from_numpy(Y.values.reshape(-1, 1)).type(torch.FloatTensor)

# 创建模型
model = nn.Sequential(
                    nn.Linear(15, 1),
                    nn.Sigmoid()
)
# 定义损失函数
loss_fn = nn.BCELoss()
# 定义优化器
opt = torch.optim.SGD(model.parameters(), lr=0.00001)
batches = 16
no_of_batches = 653//16

# 训练
for epoch in range(1000):
    for batch in range(no_of_batches):
        start = batch*batches
        end = start + batches
        x = X[start: end]
        y = Y[start: end]
        y_pred = model(x)
        loss = loss_fn(y_pred, y)
        # 把梯度清零
        opt.zero_grad()
        # 反向传播计算梯度
        loss.backward()
        # 更新梯度
        opt.step()


# 查看最终参数
model.state_dict()

# 计算准确率
((model(X).data.numpy() > 0.5).astype('int') == Y.numpy()).mean()
# 输出: 0.7243491577335375
使用面向对象的方式创建逻辑回归
import torch
import pandas as pd
import numpy as np
from torch import nn
import matplotlib.pyplot as plt


data = pd.read_csv('./dataset/HR.csv')

data = data.join(pd.get_dummies(data.part)).join(pd.get_dummies(data.salary))
data.drop(columns=['part', 'salary'], inplace=True)
Y_data = data.left.values.reshape(-1, 1)
Y = torch.from_numpy(Y_data).type(torch.FloatTensor)

X_data = data[[c for c in data.columns if c != 'left']].values
X = torch.from_numpy(X_data).type(torch.FloatTensor)

# 创建模型
class Logistic(nn.Module):
    def __init__(self):
        super().__init__()
        self.lin_1 = nn.Linear(20, 64)
        self.lin_2 = nn.Linear(64, 64)
        self.lin_3 = nn.Linear(64, 1)
        self.activate = nn.ReLU()
        self.sigmoid = nn.Sigmoid()
    def forward(self, input):
        x = self.lin_1(input)
        x = self.activate(x)
        x = self.lin_2(x)
        x = self.activate(x)
        x = self.lin_3(x)
        x = self.sigmoid(x)
        return x


lr = 0.0001

# 我们将定义一个小函数来创建我们的模型和优化器,以便将来可以重用。
def get_model():
    model = Logistic()
    return model, torch.optim.Adam(model.parameters(), lr=lr)

# 定义损失函数
loss_fn = nn.BCELoss()
model, opt = get_model()
batch = 64
no_of_batches = len(data)//batch
epochs = 100

for epoch in range(epochs):
    for i in range(no_of_batches):
        start = i*batch
        end = start + batch
        x = X[start: end]
        y = Y[start: end]
        y_pred = model(x)
        loss = loss_fn(y_pred, y)
        opt.zero_grad()
        loss.backward()
        opt.step()
print('epoch:', epoch, '   ', 'loss:', loss_fn(model(X), Y))
# 输出
# epoch: 99     loss: tensor(0.5176, grad_fn=<BinaryCrossEntropyBackward>)
使用dataset进行重构
PyTorch有一个抽象的Dataset类。Dataset可以是任何具有*len函数和_**_getitem__作为对其进行索引的方法的函数。 本教程将通过示例将自定义HRDataset类创建为的Dataset的子类。*
PyTorch的TensorDataset 是一个包装张量的Dataset。通过定义索引的长度和方式,这也为我们提供了沿张量的第一维进行迭代,索引和切片的方法。这将使我们在训练的同一行中更容易访问自变量和因变量。
from torch.utils.data import TensorDataset

HRdataset = TensorDataset(X, Y)
model, opt = get_model()
for epoch in range(epochs):
    for i in range(no_of_batches):
        x, y = HRdataset[i * batch: i * batch + batch]
        y_pred = model(x)
        loss = loss_fn(y_pred, y)
        opt.zero_grad()
        loss.backward()
        opt.step()
print('epoch:', epoch, '   ', 'loss:', loss_fn(model(X), Y))
使用DataLoader进行重构
Pytorch DataLoader负责管理批次。
DataLoader从Dataset创建。
DataLoader使遍历批次变得更容易。DataLoader会自动为我们提供每个小批量。
无需使用 HRdataset[i * batch: i * batch + batch]
from torch.utils.data import DataLoader

HR_ds = TensorDataset(X, Y)
HR_dl = DataLoader(HR_ds, batch_size=batch)
# 现在,我们的循环更加简洁了,因为(xb,yb)是从数据加载器自动加载的:

for x,y in HR_dl:
    pred = model(x)


model, opt = get_model()
for epoch in range(epochs):
    for x, y in HR_dl:
        y_pred = model(x)
        loss = loss_fn(y_pred, y)
        opt.zero_grad()
        loss.backward()
        opt.step()
print('epoch:', epoch, '   ', 'loss:', loss_fn(model(X), Y))
添加验证
前面我们只是试图建立一个合理的训练循环以用于我们的训练数据。实际上,您始终还应该具有一个验证集,以识别您是否过度拟合。
训练数据的乱序(shuffle)对于防止批次与过度拟合之间的相关性很重要。另一方面,无论我们是否乱序验证集,验证损失都是相同的。由于shufle需要额外的开销,因此shuffle验证数据没有任何意义。
我们将为验证集使用批大小,该批大小是训练集的两倍。这是因为验证集不需要反向传播,因此占用的内存更少(不需要存储梯度)。我们利用这一优势来使用更大的批量,并更快地计算损失。
from sklearn.model_selection import train_test_split


train_x, test_x, train_y, test_y = train_test_split(X_data, Y_data)
train_x = torch.from_numpy(train_x).type(torch.FloatTensor)
test_x = torch.from_numpy(test_x).type(torch.FloatTensor)
train_y = torch.from_numpy(train_y).type(torch.FloatTensor)
test_y = torch.from_numpy(test_y).type(torch.FloatTensor)

train_ds = TensorDataset(train_x, train_y)
train_dl = DataLoader(train_ds, batch_size=batch, shuffle=True)

valid_ds = TensorDataset(test_x, test_y)
valid_dl = DataLoader(valid_ds, batch_size=batch * 2)
定义计算正确率函数
def accuracy(out, yb):
    preds = (out>0.5).type(torch.IntTensor)
    return (preds == yb).float().mean()
创建fit和get_data
def loss_batch(model, loss_func, xb, yb, opt=None):
    loss = loss_func(model(xb), yb)

    if opt is not None:
        loss.backward()
        opt.step()
        opt.zero_grad()

    return loss.item(), len(xb)

import numpy as np

def fit(epochs, model, loss_func, opt, train_dl, valid_dl):
    for epoch in range(epochs):
        model.train()
        for xb, yb in train_dl:
            loss_batch(model, loss_func, xb, yb, opt)

        model.eval()
        with torch.no_grad():
            losses, nums = zip(
                *[loss_batch(model, loss_func, xb, yb) for xb, yb in valid_dl]
            )
        val_loss = np.sum(np.multiply(losses, nums)) / np.sum(nums)

        print(epoch, val_loss)

def get_data(train_ds, valid_ds, bs):
    return (
        DataLoader(train_ds, batch_size=bs, shuffle=True),
        DataLoader(valid_ds, batch_size=bs * 2),
    )

# 现在,我们获取数据加载器和拟合模型的整个过程可以在3行代码中运行:
train_dl, valid_dl = get_data(train_ds, valid_ds, batch)
model, opt = get_model()
fit(epochs, model, loss_fn, opt, train_dl, valid_dl)
输出:
0 0.5466923921585083
1 0.5437768836975098
2 0.5458150820096334
3 0.5379680653254191
4 0.5520771965344747
...
97 0.2388138730128606
98 0.24304283109505972
99 0.2423896360238393
多层感知机
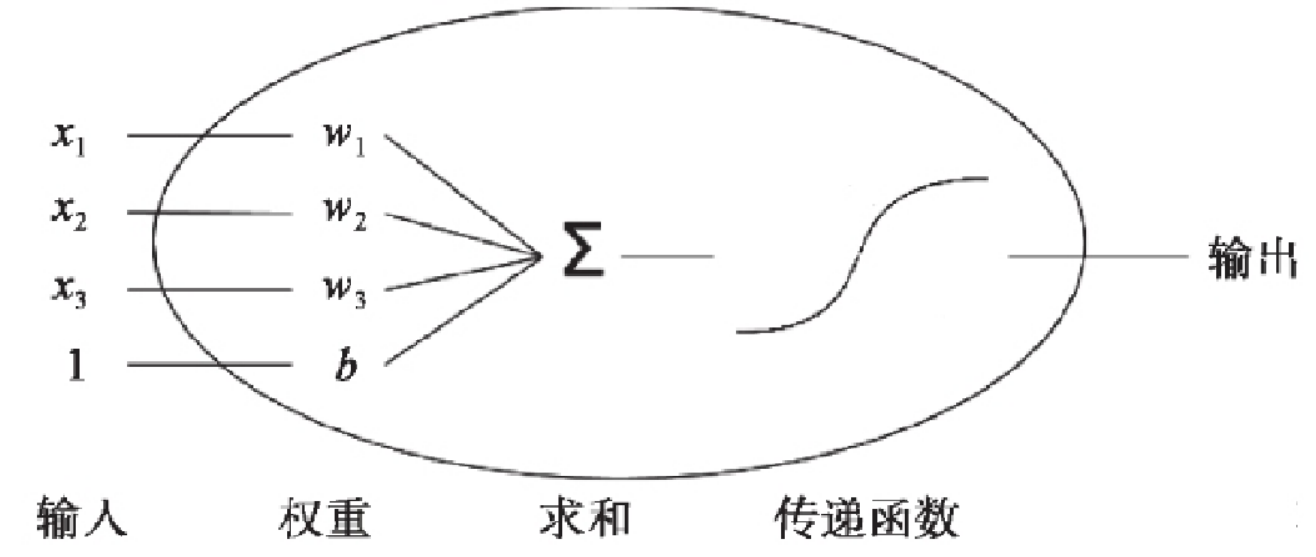
上一节我们学习的逻辑回归模型是单个神经元: 计算输入特征的加权和 然后使用一个激活函数(或传递函数)计算输出.
单个神经元(二分类):
多个神经元(多分类):

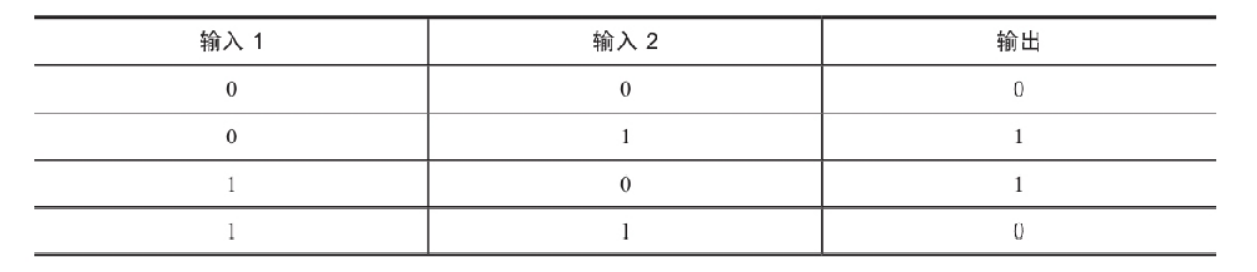
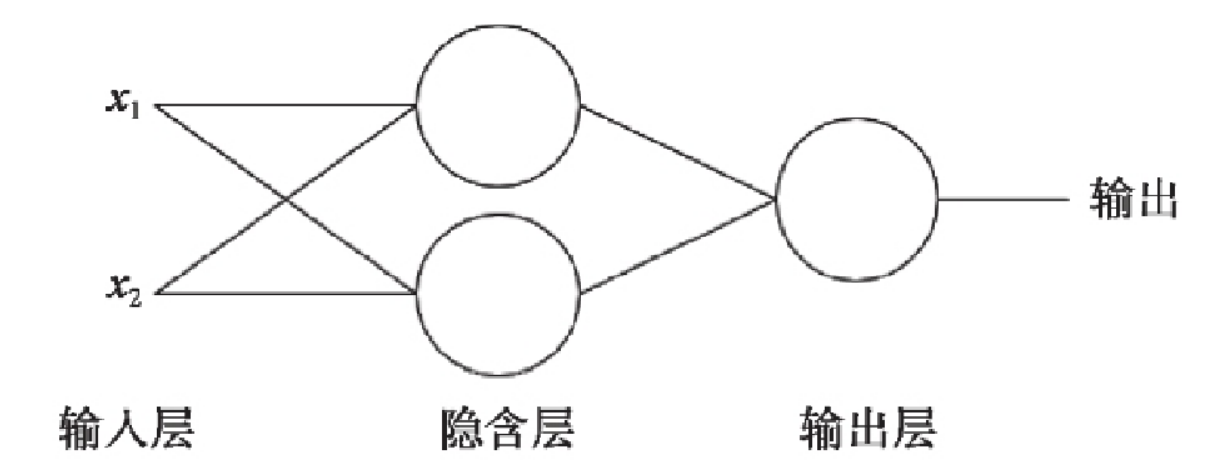
单层神经元的缺陷: 无法拟合“异或”运算 异或 问题看似简单,使用单层的神经元确实没有办法解决.神经元要求数据必须是线性可分的, 异或 问题无法找到一条直线分割两个类, 这个问题是的神经网络的发展停滞了很多年.
神经元的启发
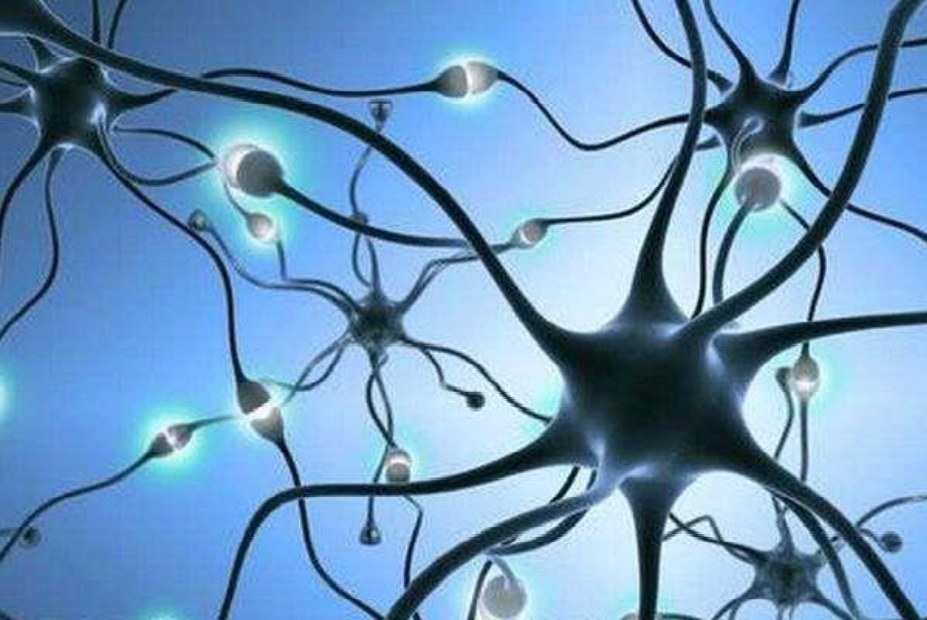
多层感知器:生物的神经元一层一层连接起来,当神经信号达到某一个条 件,这个神经元就会激活,然后继续传递信息下去 为了继续使用神经网络解决这种不具备线性可分性的问题, 采取在神经网络的输入端和输出端之间插入更多的神经元.
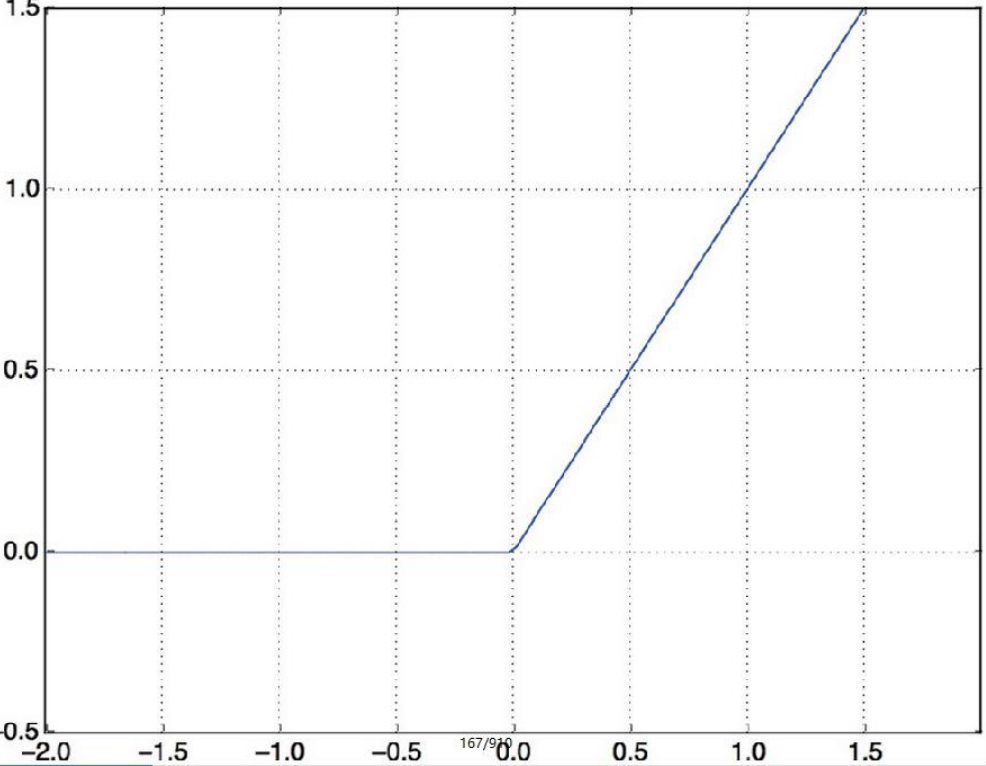
激活函数
relu:
sigmoid:
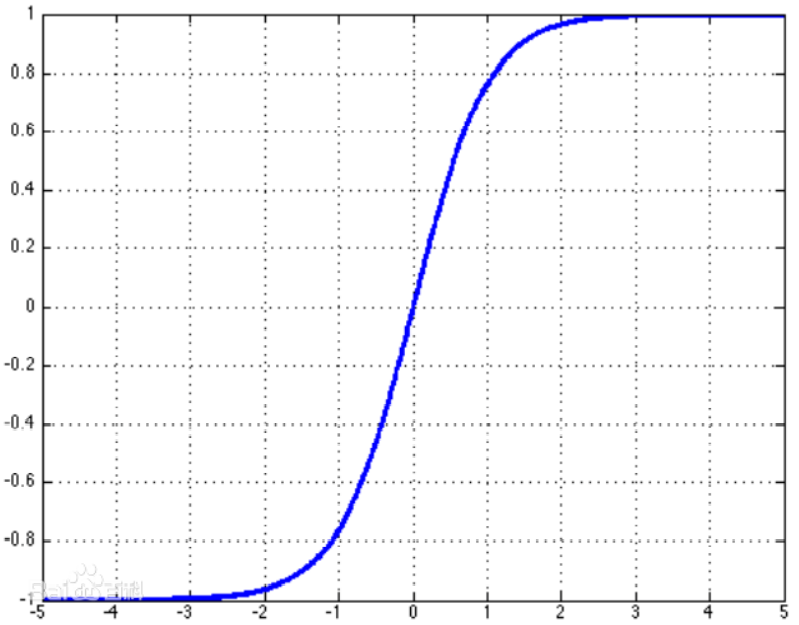
tanh:
leak relu:
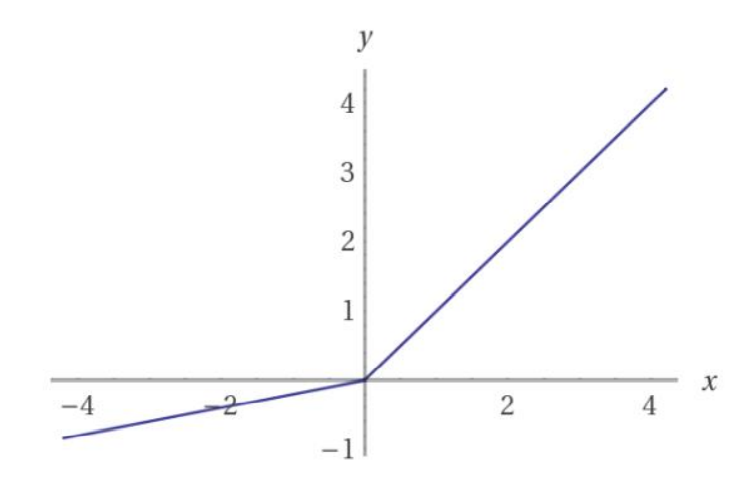
我们依然使用hr数据集创建多层感知机来做分类:
import torch
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
%matplotlib inline
from torch import nn

data = pd.read_csv('dataset/HR.csv')

data = data.join(pd.get_dummies(data.salary))

del data['salary']

data = data.join(pd.get_dummies(data.part))

del data['part']

Y_data = data.left.values.reshape(-1, 1)

Y = torch.from_numpy(Y_data).type(torch.FloatTensor)

X_data = data[[c for c in data.columns if c !='left']].values

X = torch.from_numpy(X_data).type(torch.FloatTensor)


#自定义模型:
#nn.Module: 继承这个类
#__init__:  初始化所有的层
#forward:   定义模型的运算过程(前向传播的过程)

class Model(nn.Module):
    def __init__(self):
        super().__init__()
        self.liner_1 = nn.Linear(20, 64)
        self.liner_2 = nn.Linear(64, 64)
        self.liner_3 = nn.Linear(64, 1)
        self.relu = nn.ReLU()
        self.sigmoid = nn.Sigmoid()
    def forward(self, input):
        x = self.liner_1(input)
        x = self.relu(x)
        x = self.liner_2(x)
        x = self.relu(x)
        x = self.liner_3(x)
        x = self.sigmoid(x)
        return x
借助F对象改写模型, 让模型更简洁:
import torch.nn.functional as F

class Model(nn.Module):
    def __init__(self):
        super().__init__()
        self.liner_1 = nn.Linear(20, 64)
        self.liner_2 = nn.Linear(64, 64)
        self.liner_3 = nn.Linear(64, 1)
    def forward(self, input):
        x = F.relu(self.liner_1(input))
        x = F.relu(self.liner_2(x))
        x = F.sigmoid(self.liner_3(x))
        return x