12.4.1 Flink数据传输机制
Flink架构中涉及JobManger、TaskManger角色,TaskManager中可以运行Task处理数据,为了更好的理解Flink Task之间的数据交换,我们需要先了解如下概念。
- JobManager
Flink Master节点,负责任务分配、协调、故障恢复。在JobManager中保存着Flink Job执行的逻辑拓扑图(ExecutionGraph)。
- TaskManager
Flink Worker节点,通过多线程执行task任务。每个TaskManager中包含一个CommunicationManager(负责通信,多个task之间共享)和一个MemoryManager(负责内存管理,多个task之间共享)。TaskManager之间通过TCP连接进行通信,一个TaskManager内的多个task和另一个TaskManager内的多个task之间数据通信复用同一个网络连接。在同一个TaskManager内部的多个task之间可能也需要通信,但内部通信不走网络连接,而是本地线程间的通信机制。
- ExecutionGraph

上图中的执行逻辑拓扑图由EV、IRP和EE组成。其中EV(ExecutionVertex,执行顶点)代表计算任务本身;IRP(Intermediate Result Partitioin,简称IRP/RP)代表计算任务产生的中间结果分区;EE(Execution Edge,执行边界)代表该计算任务负责消费上游任务产生的计算结果。
- ResultPartition(简称IRP/RP)
中间结果分区表示单个task任务计算后输出的一块数据写缓存区(BufferWriter),一个RP实际上包含多个Result Subpartition。
- ResultSubpartition(简称RS)
中间结果分区由上游的计算任务(EV)计算得到,其中的一个子分区对应下游的一个计算任务(EE)。
Flink任务在运行时,数据会在各个TaskManager之间进行流动交换,上游TaskManager和下游TaskManager之间的数据传输可以简单看做是生产者-消费者模式。下图展示了在Flink中数据传递交换机制,图中有两个TaskManager,每个TaskManager中各有一个maptask和reduce task,可以理解为2个算子。粗箭头代表数据流,细箭头代表系统通知。
Flink整个数据流传递交换是由数据的接收方触发的。首先,M1计算得到中间结果RP1(箭头1),当RP变的可用之后,会通知JobManager(箭头2),JobManager会将RP可用的消息通知到R1和R2(箭头3a和3b),R1和R2收到通知后会发起数据交换的请求(箭头4a和4b),该请求会触发数据的交换(箭头5a和5b),由此可见,Flink中数据交换本质上采用的是数据消费端“拉”模式。

下图更详细的描述了数据从一个TaskManager传递到另一个TaskManager的生命周期。其中有一些概念如下:
- InputGate(简称IG)
在Task中,InputGate是对输入的封装,与数据写出端的ResultPartition逻辑等价。每个InputGate消费一个或者多个ResultPartition。
- InputChannel(简称IC)
InputChannel负责收集ResultSubpartitoin中的数据。InputGate由多个InputChannel构成,InputChannel和ResultSubpartition一一相连,一个 InputChannel接收一个ResultSubpartition 的输出。
- buffer
Flink网络层数据交换的最小单元,承载序列化后的数据,以直接内存方式分配,由参数 taskmanager.memory.segment-size 配置,默认为32Kb。
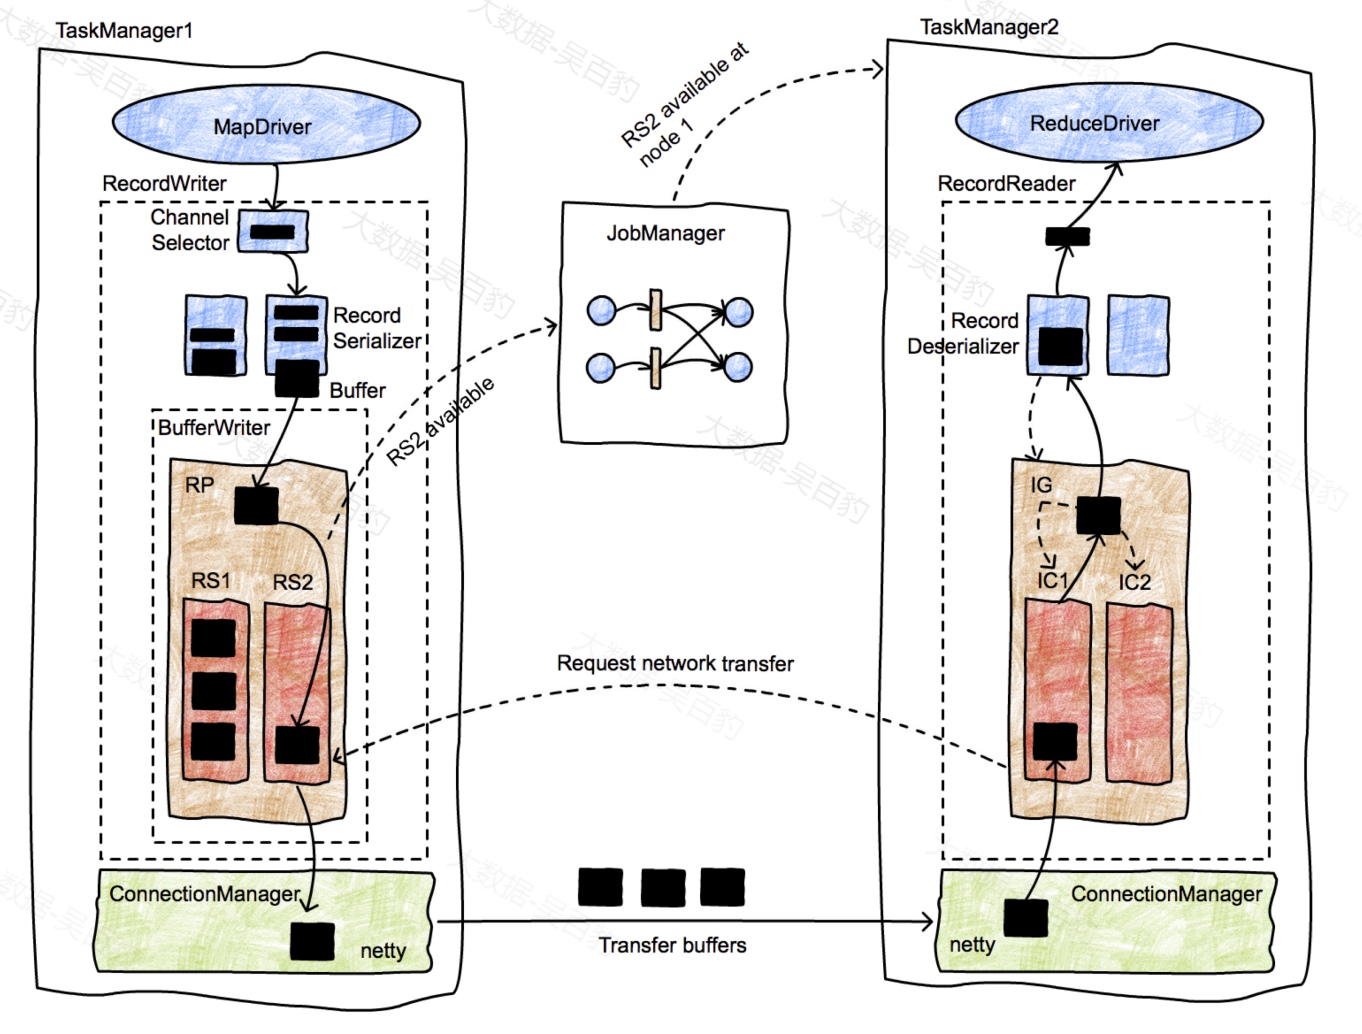
最初,MapDriver生成记录(由Collector收集),然后传递给RecordWriter对象。RecordWriters包含多个序列化器(RecordSerializer对象),每个序列化器对应可能消费这些记录的一个消费者任务。例如,在洗牌或广播中,将有与消费者任务数量相同的序列化器。ChannelSelector选择一个或多个序列化器来放置记录。例如,如果记录是广播的,它们将放置在每个序列化器中。如果记录经过哈希分区,ChannelSelector将计算记录的哈希值并选择适当的序列化器。
序列化器将记录序列化为它们的二进制表示,并将它们放置在固定大小的缓冲区中(记录可以跨越多个缓冲区)。这些缓冲区交给BufferWriter并写入ResultPartition(RP)。RP由多个子分区(ResultSubpartitions - RSs)组成,用于收集消费者消费数据的缓冲区。上图中当RS2准备好数据后,会通知JobManager数据可用。
JobManager会通知到TaskManager 2有数据块可用并查找RS2的消费者,找到应接收此缓冲区的InputChannel,然后InputChannel通知RS2可以启动网络传输。然后,RS2将缓冲区交给TM1的网络堆栈,然后由netty进行传输。TaskManager节点之间的网络连接是长期存在的,而不是每个任务都创建网络连接。
一旦缓冲区被TM2接收,数据将通过一个类似数据写出端的对象层次结构,从InputChannel开始,到InputGate,最后在RecordDeserializer中结束,该RecordDeserializer从缓冲区生成类型记录,并将它们交给接收ReduceDriver进行处理。
12.4.2 Flink数据反压机制
前面内容中我们了解了Flink数据传输机制本质上是生产者-消费者模式,这种模式中,当上游和下游数据处理的速度不一致时就会出现数据堵塞问题,为了应对这种情况,Flink引入了动态反馈机制——反压机制,这种机制可以根据实时数据传输情况调整数据的发送和接收速率,以更好的进行网络数据传输。
Flink反压机制有两种:“基于TCP的反压机制”和“基于Credit的反压机制”,Flink1.5版本之前使用“基于TCP的反压机制”,1.5版本之后默认采用“基于Credit的反压机制”,下面分别对这两种机制进行介绍。
12.4.2.1 基于TCP的反压机制

上图表示两个TaskManager之间传递数据流程,每个TaskManager中都会有个被内部所有task共享的NetworkBuffer Pool,它从堆外内存申请内存资源,可以为每个ResultSubpartition/InputChannel创建Local Buffer Pool。
假设Producer产生数据的速度比Consumer消费数据的速度快,那么经过一段时间,各层buffer被打满,从而引起反压的过程。
基于TCP的反压机制流程如下:
1) InputChannel Buffer打满
由于消费者处理速度慢,一段时间后会达到下图状态:InputChannel暂时被打满,需要向Local Buffer Pool申请新的Buffer,此时Local Buffer Pool里的一个buffer被标记为Used。

2) Consumer Local Buffer Pool打满
由于下游处理数据慢,一段时间后,InputChannel将Local Buffer Pool的内存申请完,此时Local Buffer Pool所有的buffer都被标记为Used,但还可以向Network Buffer Pool继续申请buffer。
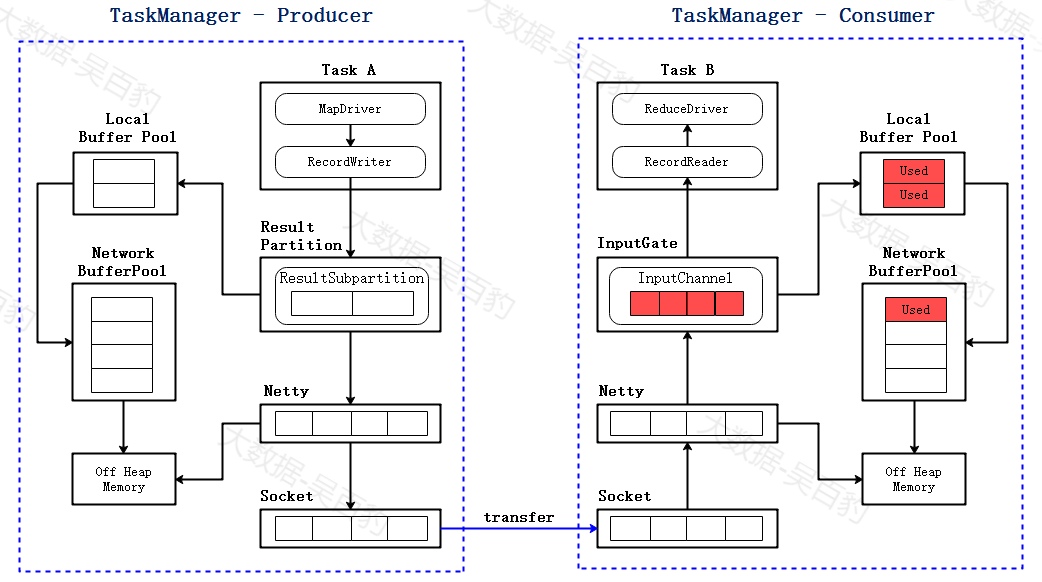
3) Consumer Network Buffer Pool 打满
慢慢的Network Buffer Pool 也没有可用的buffer,全都变成了Used,此时消费者无法再读取数据,Netty也不会接收Socket的数据。

4) Socket停止数据传输
当消费者的socket被用尽,此时会反馈给生产者端,socket会停止发送数据。

5) Netty 不可写
不久socket buffer用尽,Netty检测到后会停止向socket发送数据,之后由于RecordWriter还在发送数据,这些数据会堆积在Netty Buffer中,到一定程度后,Netty会变成不可写的状态。

6) RecordWriter 停止写数据
ResultSubpartition 空间很快被用尽,直到Local Buffer Pool 和Net Buffer Pool的Buffer都被打满后,RecordWriter就会停止写数据,至此,完成了跨TaskManager的反压。

基于TCP的反压机制有如下问题:
- 一个TaskManager内通常会有多个Task,它们底层会复用同一个Socket,一旦某个Task反压导致Socket阻塞不可用,即使其他Task关联的缓冲池仍然有空余,也都无法向TCP连接中写入数据或者从中读取数据。
- 基于底层TCP的反压机制从InputChannel到Netty再到ResultSubpartition整条链路较长,会导致反压行为不够灵敏,动态反馈过程比较迟钝。
12.4.2.2 基于Credit的反压机制
为了解决以上问题,Flink1.5后重构了网络栈,引入“基于Credit的反压机制”,主要解决了数据反压链路长、TaskManager之间网络连接在反压下处于阻塞的问题。
基于Credit的反压机制思路非常简单,它在数据接收端和发送端建立了一种类似“信用评级”的机制,发送端向接收端发送的数据永远不会超过接收端的信用值大小。对于Flink来说,信用值就是接收端TaskManager可用的buffer数量,这样就可以保证发送端TaskManager不会向TCP连接中发送超过接收端缓冲区可用容量的数据。
基于Credit实现数据反压具体流程如下:
- 当发送端发送buffer的时候,会将当前堆积数据的buffer数量(backlog size)告知接收端。
- 接收端将根据发送端堆积的数量来申请buffer。
- 接收端向发送端声明可用的Credit(一个可用的buffer对应一个credit)。
- 当接收端分配了N点Credit给发送端,表明它有N个空闲的buffer可以接收数据。
- 当发送端获得了N点Credit,表明它可以向网络中发送N个buffer。
- 只有在credit>0的情况下发送端才发送buffer,当发送端每发送一个buffer,credit也相应的减少。
如下图所示,当前ResultPartition已经堆积了两个buffer数据,在底层网络传输时会将要传输的数据以及backlog size =2 发送至接收端,下游接收到后会根据接收到的backlog sieze及剩余的buffer计算credit信用值,假设这里返回credit为5,表示接收端还可以接收5个buffer数据。

当接收端各级buffer打满后,下游会向上游返回credit为0,说明由于上下级处理速率不一致,导致了下游暂时无法处理数据,此时ResultPartition就不会向Netty传输数据,数据很快打满,从而达到反压效果。

基于Credit的反压机制主要解决了如下问题:
- 可以在ResultPartition层面实现反压,而不用将压力流经多层传递,层层反馈,降低了延迟。
- 不会把底层socket打满,从而阻碍网络传输数据,不会让单个Task的瓶颈成为整个TaskManager的瓶颈。
12.4.3 网络内存优化
Flink中每条消息都会被放到网络缓冲(network buffer)中,并以此为最小单位发送到下一个subtask,为了维持连续的高吞吐,Flink在传输数据过程中输入端和输出端都有多个本地缓冲区池。每个输出和输入流对应的缓冲区池的目标缓冲区数由下面公式计算得到。
channels*taskmanager.network.memory.buffers-per-channel+ taskmanager.network.memory.floating-buffers-per-gate
以上公式中channels表示通道,即输入/输出的并行度,通过该公式可以计算输出和输入缓冲区使用的buffer总数量,然后根据每个缓冲区(Buffer)的大小(可通过参数taskmanager.memory.segment-size 来设置)可以估算Flink每个操作输入/输出缓冲区大小。
关于输出/输入缓冲区的一些参数配置项解释如下:
- taskmanager.memory.segment-size
该值表示一个网络缓冲(network buffer)大小,默认值32kb。
- taskmanager.network.memory.buffers-per-channel
该参数表示在基于 credit 的流控制模型中,每个 Subpartition/Input Channel 独占网络缓冲区数,默认值为2。对于Subpartition,该值是每个channel的有效独占buffer数;对于InputChannel,该值是每个channel独占buffer的最大值,每个channel的有效独占buffer数量根据taskmanager.network.memory.read-buffer.required-per-gate.max 动态计算,有效范围从0到配置值。
- taskmanager.network.memory.read-buffer.required-per-gate.max
该值表示InputGate所需的网络读缓冲区(buffer)的最大数目阈值,在Flink流式计算中该值默认为Integer.MAX_VALUE,在Flink批处理中,该值为1000。InputGate所需的缓冲区数量取决于各种因素(例如上游任务的并行度),会在运行时动态计算。当动态计算得到的网络缓冲区数目小于该阈值的部分被称为必须(Required)缓冲区,剩余的部分(如果有的话)是可选(Optional)缓冲区,如果无法获得必须缓冲区,会导致Flink任务失败,如果无法获得可选缓冲区,Flink任务不会失败,但可能会降低性能。
通常,该阈值越小,出现“网络缓冲区数量不足”异常的可能性越小,但Flink工作性能可能会降低,反之依然。不建议用户更改该值,除非用户有充足的理由修改它,并明确该阈值带来的影响。
- taskmanager.network.memory.floating-buffers-per-gate
该参数表示在基于 credit 的流控制模型中,每个ResultPartition/Inputgates在所有channels之间能共享的浮动网络缓冲区(buffer)数目,默认为8。浮动buffers可以缓解由于Subpartitions之间数据分布不平衡而造成的背压问题。对于ResultPartition,该值是每个ResultPartition有效浮动buffer数;对于InputGate,每个InputGate的有效浮动网络缓冲区的数量是根据taskmanager.network.memory.read-buffer.required-per-gate.max动态计算,有效浮动缓冲区的范围是从0到(parallelism-1)。
- taskmanager.network.memory.max-overdraft-buffers-per-gate
该参数表示每个ResultPartition使用的最大透支网络缓冲区数,默认值为5。当 subtask 被下游 subtasks 反压且当前 subtask 需要请求超过 1 个网络缓冲区(network buffer)才能完成当前的操作时,将使用透支缓冲区,例如序列化大记录,不能放入单个网络缓冲区中;为单个输入记录生成多个记录的flatMap操作;或周期性地或某些事件触发产生大量 records 的算子(例如:WindowOperator 的触发)。在这种情况下,系统将允许subtask请求透支缓冲区,这样子任务就可以完成这种不可中断的操作,而不会长时间阻塞unaligned checkpoints。只有当系统有一些未使用的缓冲区可用时,才会提供透支缓冲区,使用透支缓冲区的subtask将不允许再处理任何记录,直到透支缓冲区返回到池中。
12.4.3.1 网络缓存消胀(Buffer Debloating)机制
在Flink中进行checkpoint时,需要所有的subtask都收到对应的barrier才能完成checkpoint快照。在barrier对齐或者非对齐的checkpoint场景中,只要多个subtask处理数据速度不一致都需要缓存数据更多数据,这些数据就存放在网络缓冲(network buffer)中。关于网络缓存,一般只需要调整内存参数taskmanager.memory.network.fraction(网络缓存占Flink总内存taskmanager.memory.flink.size的比例,默认值0.1)即可。内部一些网络输出/输入缓冲区的一些参数默认也都是静态的(通过指定缓冲区的数量和大小),针对同一个Flink应用运行时,需要调节这些网络缓存底层参数时很难有统一的完美参数,如果缓存大量数据会导致内存空间浪费以及checkpoint时间过长。为了解决以上这个问题,Flink1.14引入了网络缓存消胀(Network Buffer Debloating)机制尝试通过自动调整缓冲数据量到一个合理值。
网络缓冲消胀机制原理是根据一个预设的消费时间阈值和一定时间段内的数据吞吐量来动态调节接收端的Buffer大小。可以通过设置 taskmanager.network.memory.buffer-debloat.enabled 为 true 来开启缓冲消胀机制。关于网络缓存消胀机制更多可调参数如下:
- taskmanager.network.memory.buffer-debloat.target:缓存数据被接收方消费的期望时间阈值,默认1s。默认值能满足大多数场景。
- taskmanager.network.memory.buffer-debloat.period:这是缓冲区大小重算的最小时间周期。默认值200ms。周期越小,缓冲消胀机制的反应时间就越快,但是必要的计算会消耗更多的CPU。
- taskmanager.network.memory.buffer-debloat.samples:调整用于计算平均吞吐量的采样数。默认20。采集样本的频率可以通过 taskmanager.network.memory.buffer-debloat.period 来设置。样本数越少,缓冲消胀机制的反应时间就越快,但是当吞吐量突然飙升或者下降时,缓冲消胀机制计算的最佳缓冲数据量会更容易出错。
- taskmanager.network.memory.buffer-debloat.threshold-percentages:缓存消胀过程中的新旧Buffer相对变化率的阈值,默认为25(即25%)。若变化率小于此值,则不执行Debloat操作,可以避免频繁调整产生性能抖动。
以上参数一般选择默认值即可,只需要设置开启缓存消胀机制即可,如果Flink作业复杂经常变化,例如:突如其来的数据尖峰、定期窗口聚合、大量数据join ,可以适当减少taskmanager.network.memory.buffer-debloat.period、taskmanager.network.memory.buffer-debloat.samples参数,以到达更快自动调节缓冲区大小目的。
网络缓存消胀机制使用目前也有一些限制,如下:
- 如果Flink作业中的subtask有很多不同的输入或者有一个合并的输入,开启缓存消胀机制后可能会导致低吞吐的subtask输入有太多缓存数据,从而导致高吞吐输入的缓冲区数量太少而不够维持当前吞吐。
- 开启缓存消胀机制与Flink应用程序使用的缓冲区大小不冲突,也就是说缓存消胀机制仅在使用的缓冲区上设置上限,Flink作业实际的缓冲区大小和个数保持不变。
12.4.3.2 缓冲区大小和数量建议
- 关于缓冲区大小建议
网络缓冲区用于收集记录,以优化将数据部分发送到下一个子任务时的网络开销,保证数据传输的高吞吐,如果缓冲区太小,或缓冲区刷新太频繁,由于每个缓冲区的开销明显高于Flink运行时的每条记录开销,这可能导致吞吐量下降。如果缓冲区太大,会导致内存使用增多、checkpoint变大、checkpoint周期变长、内存使用率低(当缓冲区刷新周期较短时,默认100ms,可能缓冲区还没有被塞满,数据就被发送到下游,导致分配内存使用效率低下)这些问题,所以根据经验,我们不建议考虑增加缓冲区大小,保持默认值即可,除非在实际Flink任务中观察到网络瓶颈。
- 关于缓冲区数量建议
通过前面小节的学习,我们了解到缓冲区的数量是通过taskmanager.network.memory.buffers-per-channel和taskmanager.network.memory.floating-buffers-per-gate 来配置的。为了最好的吞吐率,关于缓冲区数量调优总体思路是建议使用独占缓冲区和流动缓冲区的默认值,如果缓冲数据量存在问题,更建议打开缓冲消胀。
如果吞吐效果不佳,你可以关闭缓冲消胀机制并人工调整网络缓冲区个数。需要注意以下三点。
- 可以通过如下公式计算维持吞吐所需要的缓冲区数量
number_of_buffers = expected_throughput * buffer_roundtrip / buffer_size
expected_throughput 表示期待的数据吞吐量(单位bytes/second);buffer_roundtrip表示数据在节点之间往返时间延迟,一般为1ms;buffer_size表示缓冲区大小,默认为32kb。例如,期待吞吐量为 320MB/s,往返延迟为 1ms,缓冲区为默认大小,为了维持吞吐需要使用10个活跃的缓冲区(number_of_buffers = 320MB/s * 1ms / 32KB = 10)。
- 流动缓冲区的目的是为了处理数据倾斜。理想情况下,流动缓冲区的数量(默认8个)和每个通道独占缓冲区的数量(默认2个)能够使网络吞吐量饱和。
- 独占缓冲区的目的是提供一个流畅的吞吐量,也就是当一个缓冲区在传输数据时,另一个缓冲区被填充。当吞吐量比较高时,独占缓冲区的数量是决定 Flink 中缓冲数据的主要因素,可以适当增加独占缓冲区;当低吞吐量下出现反压时,应该考虑减少独占缓冲区,这种情况下数据处理慢,给太多独占缓冲区也是浪费内存。