在Flink中除了DataStream API之外,还有Table和SQL API ,Table API 和 SQL 是高效优化过的,它集成了许多查询优化和算子优化,但并不是所有的优化都是默认开启的,因此对于某些工作负载,可以通过打开某些选项来提高性能。在实际工作场景中我们使用FlinkSQL居多,本小节根据Flink SQL使用来介绍Table和SQL中的一些优化内容。
12.7.1 对状态设置TTL
在Flink编程中如果涉及到的状态较大并且业务允许清空状态,可以设置ttl参数,指定状态超过一定时间后自动清空,来达到减少状态效果。
Flink Table和SQL中可以通过TableEnvironment来指定table.exec.state.ttl参数,决定状态保存的时长。
下面通过代码方式来演示Flink Table API和SQL编程中状态的使用,该案例读Socket中基站日志数据,按照基站进行分组统计基站的通话时长。
//获取DataStream的运行环境
StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();

//获取Table API的运行环境
StreamTableEnvironment tableEnv = StreamTableEnvironment.create(env);

//设置状态保存时间,默认为0,表示不清理状态,这里设置5s
tableEnv.getConfig().set("table.exec.state.ttl","5000");

SingleOutputStreamOperator<StationLog> ds = env.socketTextStream("node5", 9999)
        .map(new MapFunction<String, StationLog>() {
            @Override
            public StationLog map(String s) throws Exception {
                String[] split = s.split(",");
                return new StationLog(split[0], split[1], split[2], split[3], Long.valueOf(split[4]), Long.valueOf(split[5]));
            }
        });

//将DataStream转换成Table
tableEnv.createTemporaryView("station_tbl",ds);

//通过SQL统计通话时长信息
Table result = tableEnv.sqlQuery("select sid,sum(duration) as total_duration from station_tbl group by sid");

//打印输出
result.execute().print();
以上代码运行后,向socket-9999端口中输入基站日志数据,对于连续5秒内输入的相同基站日志数据,Flink 会对基站统计的通话时长数据进行状态保存,当相同基站日志数据隔5秒后再次输入,可以看到该基站统计数据会重新统计。
#socket-9999中输入数据
001,181,182,success,1000,40
002,182,183,result,3000,20
001,183,184,success,2000,30

#隔5s后输入,可以看到基站001的统计重新开始
001,184,185,success,6000,50
12.7.2 使用累积窗口
累积窗口是Flink SQL中特有的窗口函数。滚动窗口和滑动窗口适合固定周期统计指标,除了这种固定周期统计指标场景外,还有一种特殊场景:当统计周期较长时,需要在统计周期内间隔输出某指标的统计值,并且这些输出的值是逐步累积的,这种情况下滚动窗口和滑动窗口就不能满足需求,这种场景中就可以使用累积窗口来解决。
例如:我们按天来实时统计网站的PV,每小时输出今天到此刻PV总量。如果我们设置1天一个滑动窗口,那么需要等到24点才会计算一次,这样输出频率太低,满足不了我们的需求;如果每隔一段时间统计过去1天的PV值,这样虽然计算频率增高,但是计算的结果并不是我们想要的今天到此刻的PV值。这种特殊的窗口统计就是“累积窗口”,我们可以通过Flink SQL提供的累计窗口表值函数来解决。
Flink SQL中通过CUMULATE 表值函数来设置累积窗口,如下:
CUMULATE(TABLE data, DESCRIPTOR(timecol), step, size)
CUMULATE 参数解释如下:
- data:指定Table 表。
- timecol:指定表中的时间列,必须是TIMESTAMP或者TIMESTAMP_LTZ类型。
- step:指定窗口累积步长,即多久输出一次累积结果。
- size:指定窗口长度,即多久生成一个窗口。
CUMULATE 表值函数在流处理模式下,时间属性字段必须是事件时间或处理时间属性,在批处理模式下,窗口表函数的时间属性字段必须是TIMESTAMP或TIMESTAMP_LTZ类型的属性。与TUMBLE表值函数一样,CUMULATE 的返回值包括原始关系的所有列,以及额外的三列,分别命名为“window_start”(窗口起始时间)、“window_end”(窗口结束时间)和“window_time”(窗口时间),这里的window_time窗口时间表示该窗口中包含的事件时间最大值,该值为window_end-1ms。原始时间属性“timecol”将在窗口表值函数之后成为常规的时间戳列。下面通过一个案例来演示Flink SQL 中累积窗口使用。
案例:读取Kafka中基站日志数据,按日统计,每5s输出每个基站所有主叫通话时长。
//创建TableEnvironment
EnvironmentSettings settings = EnvironmentSettings.newInstance()
        .inStreamingMode()
        .build();
TableEnvironment tableEnv = TableEnvironment.create(settings);

//当某个并行度5秒没有数据输入时,自动推进watermark
tableEnv.getConfig().set("table.exec.source.idle-timeout","5000");


//读取Kafka基站日志数据,通过SQL DDL方式定义表结构
tableEnv.executeSql("" +
        "create table stationlog_tbl (" +
        "   sid string," +
        "   call_out string," +
        "   call_in string," +
        "   call_type string," +
        "   call_time bigint," +
        "   duration bigint," +
        "   time_ltz AS TO_TIMESTAMP_LTZ(call_time,3)," +
        "   WATERMARK FOR time_ltz AS time_ltz - INTERVAL '2' SECOND" +
        ") with (" +
        "   'connector' = 'kafka'," +
        "   'topic' = 'stationlog-topic'," +
        "   'properties.bootstrap.servers' = 'node1:9092,node2:9092,node3:9092'," +
        "   'properties.group.id' = 'testGroup'," +
        "   'scan.startup.mode' = 'latest-offset'," +
        "   'format' = 'csv'" +
        ")");

//SQL TumblingWindow
Table result = tableEnv.sqlQuery("select " +
        "sid,window_start,window_end,sum(duration) as sum_dur " +
        "from TABLE(" +
        "   CUMULATE(TABLE stationlog_tbl,DESCRIPTOR(time_ltz), INTERVAL '5' SECOND , INTERVAL '1' DAY)" +
        ") " +
        "group by sid,window_start,window_end");

//打印结果
result.execute().print();
代码编写完成后,可以向Kafka stationlog-topic中输入如下数据,可以看到随着数据的输入,每隔5秒会展示一次当日统计结果。
#向kafka stationlog-topic中输入如下数据
001,181,182,busy,1000,10
002,182,183,fail,3000,20
001,183,184,busy,2000,30
002,184,185,busy,6000,40
003,181,183,busy,5000,50
#[0~5000)窗口触发
001,181,182,busy,7000,10
002,182,183,fail,9000,20
001,183,184,busy,11000,30
002,184,185,busy,6000,40
#[0~10000)窗口触发
003,181,183,busy,12000,50
#[5000~15000)窗口触发
003,181,183,busy,17000,50
控制台输出结果如下:
+----+-----+-------------------------+-------------------------+--------+
| op | sid |            window_start |              window_end |sum_dur |
+----+-----+-------------------------+-------------------------+--------+
| +I | 001 | 1970-01-01 00:00:00.000 | 1970-01-01 08:00:05.000 |     40 |
| +I | 002 | 1970-01-01 00:00:00.000 | 1970-01-01 08:00:05.000 |     20 |
| +I | 001 | 1970-01-01 00:00:00.000 | 1970-01-01 08:00:10.000 |     50 |
| +I | 003 | 1970-01-01 00:00:00.000 | 1970-01-01 08:00:10.000 |     50 |
| +I | 002 | 1970-01-01 00:00:00.000 | 1970-01-01 08:00:10.000 |    120 |
| +I | 001 | 1970-01-01 00:00:00.000 | 1970-01-01 08:00:15.000 |     80 |
| +I | 003 | 1970-01-01 00:00:00.000 | 1970-01-01 08:00:15.000 |    100 |
| +I | 002 | 1970-01-01 00:00:00.000 | 1970-01-01 08:00:15.000 |    120 |
12.7.3 MiniBatch聚合
Flink Table和SQL聚合场景中默认来一条数据聚合一条,聚合过程往往涉及状态操作所以每来一条数据聚合处理过程为:从状态中获取数据——>状态累加——>状态更新写出,这种来一条聚合一条数据处理模式可能会增加StateBackend开销(尤其是对于RocksDB StateBackend),如果遇到数据倾斜,会加剧这个开销并容易导致job反压。
这种聚合场景下,为了进一步减少StateBackend开销,在Flink Table和SQL 中我们可以设置开启MiniBatch聚合(默认关闭),其核心思想是将一组输入的数据缓存在聚合算子内部的缓冲区中,经过一定时间后再做触发处理,触发前会进行本地局部聚合,这样在触发处理时,每个key只需要一次访问状态,可以大大减少状态开销并获得更好的吞吐量。主要注意,开启MiniBatch聚合后,由于不是立即处理实时数据可能会增加Flink一些延迟,所以开启或者不开启MiniBatch聚合是吞吐量和延迟之间的权衡。

Flink Table和SQL中T默认MiniBatch优化是关闭的,Table和SQL 操作中可以通过设置如下选项进行开启。
// 初始化 table environment
TableEnvironment tEnv = ...;
//通过flink configuration进行参数设置
TableConfig configuration = tEnv.getConfig();
//开启MiniBatch 优化,默认false
configuration.set("table.exec.mini-batch.enabled", "true");
//设置5秒时间处理缓冲数据,默认0s
configuration.set("table.exec.mini-batch.allow-latency", "5 s");
//设置每个聚合操作可以缓冲的最大记录数,默认-1,开启MiniBatch后必须设置为正值
configuration.set("table.exec.mini-batch.size", "5000");
代码案例:
//1.使用本地模式
Configuration conf = new Configuration();
//设置WebUI绑定的本地端口
conf.setString(RestOptions.BIND_PORT,"8081");
//使用配置
StreamExecutionEnvironment env = StreamExecutionEnvironment.createLocalEnvironmentWithWebUI(conf);

//创建流处理执行环境
//StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();

//2.创建TableEnv
StreamTableEnvironment tableEnv = StreamTableEnvironment.create(env);

//3.开启minibatch
//通过flink configuration进行参数设置
TableConfig configuration = tableEnv.getConfig();
//开启MiniBatch 优化,默认false
configuration.set("table.exec.mini-batch.enabled", "true");
//设置5秒时间处理缓冲数据,默认0s
configuration.set("table.exec.mini-batch.allow-latency", "5 s");
//设置每个聚合操作可以缓冲的最大记录数,默认-1,开启MiniBatch后必须设置为正值
configuration.set("table.exec.mini-batch.size", "5000");

DataStreamSource<StationLog> ds1 = env.addSource(new RichParallelSourceFunction<StationLog>() {
    Boolean flag = true;

    @Override
    public void run(SourceContext<StationLog> ctx) throws Exception {
        Random random = new Random();
        String[] callTypes = {"fail", "success", "busy", "barring"};
        while (flag) {
            String sid = "sid_" + random.nextInt(10);
            generateData(ctx, random, sid, callTypes);
            Thread.sleep(50);

        }

    }

    private void generateData(SourceContext<StationLog> ctx, Random random, String sid, String[] callTypes) {
        String callOut = "1811234" + (random.nextInt(9000) + 1000);
        String callIn = "1915678" + (random.nextInt(9000) + 1000);
        String callType = callTypes[random.nextInt(4)];
        Long callTime = System.currentTimeMillis();
        Long durations = Long.valueOf(random.nextInt(50) + "");
        ctx.collect(new StationLog(sid, callOut, callIn, callType, callTime, durations));
    }

    //当取消对应的Flink任务时被调用
    @Override
    public void cancel() {
        flag = false;
    }
});

//将DataStream 转换成 Table
tableEnv.createTemporaryView("stationlog_tbl", ds1);

//打印表结构
Table table = tableEnv.from("stationlog_tbl");
table.printSchema();

TableResult result = tableEnv.executeSql("select sid,sum(duration) as totalDuration from stationlog_tbl group by sid");
result.print();
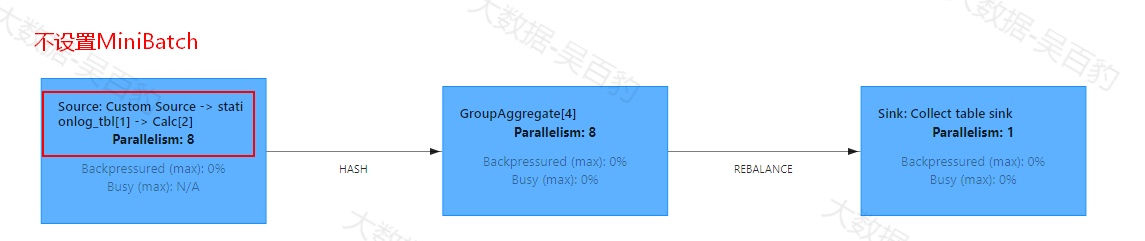
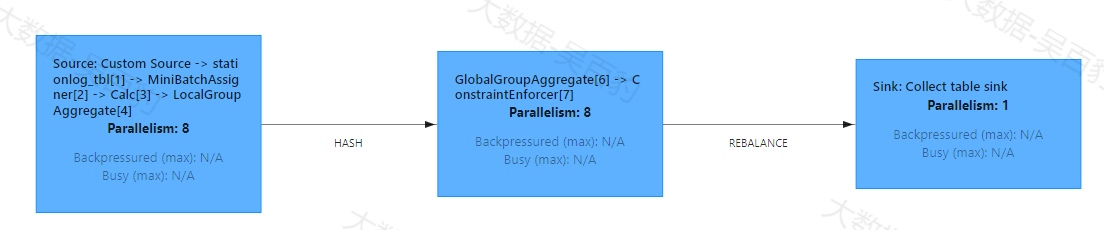
以上代码中不开启minibatch和设置minibatch可以通过WebUI页面看到变化:

12.7.4 Local-Global聚合
Local-Global聚合主要解决Table 和 SQL操作中的数据倾斜问题,其思想是通过将一组聚合分为两个阶段,先在上游进行本地聚合,然后再下游进行全局聚合,类似MapReduce中的Combine+Reduce模式。如下SQL:
SELECT color, sum(id)
FROM T
GROUP BY color
以上SQL当按照Color进行分组聚合处理时,可能由于各Color存在数据不均衡出现一些并行实例处理相比其他实例处理更多的记录。开启Local-Global聚合后,可以将具有相同key的输入数据在本地预先聚合,然后全局聚合将预聚合结果进行最后累加,这样大大减少了网络shuffle和状态访问的成本,每次本地聚合累积的输入数据量基于 mini-batch 间隔,这意味着 local-global 聚合依赖于启用了 mini-batch 优化。
下图展示了local-global聚合实现原理:

可以在Flink Table和SQL编程中通过如下参数开启local-global:
// 初始化 table environment
TableEnvironment tEnv = ...;
//通过flink configuration进行参数设置
TableConfig configuration = tEnv.getConfig();
//开启MiniBatch 优化,默认false
configuration.set("table.exec.mini-batch.enabled", "true");
//设置5秒时间处理缓冲数据,默认0s
configuration.set("table.exec.mini-batch.allow-latency", "5 s");
//设置每个聚合操作可以缓冲的最大记录数,默认-1,开启MiniBatch后必须设置为正值
configuration.set("table.exec.mini-batch.size", "5000");
//设置Local-Global 聚合
configuration.set("table.optimizer.agg-phase-strategy", "TWO_PHASE");
如下代码中在产生基站数据时将sid_0多生产很多,这样导致后续按照基站进行分组统计时出现数据倾斜问题:
//1.使用本地模式
Configuration conf = new Configuration();
//设置WebUI绑定的本地端口
conf.setString(RestOptions.BIND_PORT,"8081");
//使用配置
StreamExecutionEnvironment env = StreamExecutionEnvironment.createLocalEnvironmentWithWebUI(conf);

//创建流处理执行环境
//StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();

//2.创建TableEnv
StreamTableEnvironment tableEnv = StreamTableEnvironment.create(env);

DataStreamSource<StationLog> ds1 = env.addSource(new RichParallelSourceFunction<StationLog>() {
    Boolean flag = true;

    /**
     * 主要方法:启动一个Source,大部分情况下都需要在run方法中实现一个循环产生数据
     * 这里计划1s 产生1条基站数据,由于是并行,当前节点有几个core就会有几条数据
     */
    @Override
    public void run(SourceContext<StationLog> ctx) throws Exception {
        Random random = new Random();
        String[] callTypes = {"fail", "success", "busy", "barring"};

        // 获取当前子任务的索引
        int subtaskIndex = getRuntimeContext().getIndexOfThisSubtask();

        while (flag) {
            String sid = "sid_" + random.nextInt(10);

            // 如果是0号子任务,生成更多数据
            if (subtaskIndex == 0) {
                for (int i = 0; i < 100; i++) {
                    // 数据生成逻辑
                    generateData(ctx, random, sid, callTypes);
                }
            } else {
                // 数据生成逻辑
                generateData(ctx, random, sid, callTypes);
            }
            Thread.sleep(50);

        }

    }

    private void generateData(SourceContext<StationLog> ctx, Random random, String sid, String[] callTypes) {
        String callOut = "1811234" + (random.nextInt(9000) + 1000);
        String callIn = "1915678" + (random.nextInt(9000) + 1000);
        String callType = callTypes[random.nextInt(4)];
        Long callTime = System.currentTimeMillis();
        Long durations = Long.valueOf(random.nextInt(50) + "");
        if (sid.equals("sid_0")) {
            for (int i = 0; i < 100; i++) {
                ctx.collect(new StationLog(sid, callOut, callIn, callType, callTime, durations));

            }
        }
        ctx.collect(new StationLog(sid, callOut, callIn, callType, callTime, durations));
    }

    //当取消对应的Flink任务时被调用
    @Override
    public void cancel() {
        flag = false;
    }
});

//将DataStream 转换成 Table
tableEnv.createTemporaryView("stationlog_tbl", ds1);

//打印表结构
Table table = tableEnv.from("stationlog_tbl");
table.printSchema();

TableResult result = tableEnv.executeSql("select sid,sum(duration) as totalDuration from stationlog_tbl group by sid");
result.print();
查看Flink WebUI可以观察到存在数据倾斜问题:


代码中设置Local-Global聚合后,数据倾斜问题被很大程度解决。在以上代码中增加Local-Global聚合设置。
... ...
//2.创建TableEnv
StreamTableEnvironment tableEnv = StreamTableEnvironment.create(env);

//3.开启Local-Global 聚合
//通过flink configuration进行参数设置
TableConfig configuration = tableEnv.getConfig();
//开启MiniBatch 优化,默认false
configuration.set("table.exec.mini-batch.enabled", "true");
//设置5秒时间处理缓冲数据,默认0s
configuration.set("table.exec.mini-batch.allow-latency", "5 s");
//设置每个聚合操作可以缓冲的最大记录数,默认-1,开启MiniBatch后必须设置为正值
configuration.set("table.exec.mini-batch.size", "5000");
//设置Local-Global 聚合
configuration.set("table.optimizer.agg-phase-strategy", "TWO_PHASE");


DataStreamSource<StationLog> ds1 = env.addSource...
... ...
通过WebUI可以看到开启Local-Global聚合后,数据处理中没有出现数据倾斜。


12.7.5 拆分distinct聚合
Local-Global 优化可有效消除常规聚合的数据倾斜,例如 SUM、COUNT、MAX、MIN、AVG。但是在处理 distinct 聚合时,其性能并不令人满意。例如,如果我们要分析今天有多少唯一用户登录。我们可能有以下查询:
SELECT day, COUNT(DISTINCT user_id)
FROM T
GROUP BY day
如果 distinct key (即 user_id)的值分布稀疏且出现数据倾斜,则 COUNT DISTINCT 不适合减少数据,即使启用了 local-global 优化也没有太大帮助,因为每个并行可能仍然包含几乎所有原始记录,并且全局聚合将成为瓶颈(大多数繁重的累计操作由一个并行实例处理)。
以上这种优化就可以使用拆分distinct聚合方式来解决。其优化原理是将不同的聚合(例如 COUNT(DISTINCT col))分为两个级别。第一次聚合由 group key 和额外的 bucket key 进行 shuffle。bucket key 是使用 HASH_CODE(distinct_key) % BUCKET_NUM 计算的。BUCKET_NUM 默认为1024,可以通过 table.optimizer.distinct-agg.split.bucket-num 选项进行配置。第二次聚合是由原始 group key 进行 shuffle,并使用 SUM 聚合来自不同 buckets 的 COUNT DISTINCT 值。由于相同的 distinct key 将仅在同一 bucket 中计算,因此转换是等效的。bucket key 充当附加 group key 的角色,以分担 group key 中热点的负担。bucket key 使 job 具有可伸缩性来解决不同聚合中的数据倾斜/热点。
拆分distinct聚合后,以上查询将自动改写为如下查询:
SELECT day, SUM(cnt)
FROM (
SELECT day, COUNT(DISTINCT user_id) as cnt
FROM T
GROUP BY day, MOD(HASH_CODE(user_id), 1024)
)GROUP BY day
下图显示了拆分 distinct 聚合如何提高性能(假设颜色表示 days,字母表示 user_id)。

拆分distinct聚合时有如下两个注意点:
- 上面是可以从这个优化中受益的最简单的示例。除此之外,Flink 还支持拆分更复杂的聚合查询,例如,多个具有不同 distinct key (例如 COUNT(DISTINCT a), SUM(DISTINCT b) )的 distinct 聚合,可以与其他非 distinct 聚合(例如 SUM、MAX、MIN、COUNT )一起使用。
- 当前拆分优化不支持包含用户定义的 AggregateFunction 聚合。
在Flink Table和SQL编程中设置拆分distinct聚合优化方式如下:
//初始化 table environment
TableEnvironment tEnv = ...;
//通过flink configuration进行参数设置
TableConfig configuration = tEnv.getConfig();
//开启拆分distinct 聚合
configuration.set("table.optimizer.distinct-agg.split.enabled", "true");
如下案例中,按照基站分组对通话类型去重统计,即使设置了Local-Global聚合操作,在不开启拆分distinct 聚合时,最终处理数据还是存在各个Task处理数据不均衡问题。
//1.使用本地模式
Configuration conf = new Configuration();
//设置WebUI绑定的本地端口
conf.setString(RestOptions.BIND_PORT,"8081");
//使用配置
StreamExecutionEnvironment env = StreamExecutionEnvironment.createLocalEnvironmentWithWebUI(conf);

//创建流处理执行环境
//StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();

//2.创建TableEnv
StreamTableEnvironment tableEnv = StreamTableEnvironment.create(env);


//通过flink configuration进行参数设置
TableConfig configuration = tableEnv.getConfig();
//开启MiniBatch 优化,默认false
configuration.set("table.exec.mini-batch.enabled", "true");
//设置5秒时间处理缓冲数据,默认0s
configuration.set("table.exec.mini-batch.allow-latency", "5 s");
//设置每个聚合操作可以缓冲的最大记录数,默认-1,开启MiniBatch后必须设置为正值
configuration.set("table.exec.mini-batch.size", "5000");
//设置Local-Global 聚合
configuration.set("table.optimizer.agg-phase-strategy", "TWO_PHASE");


DataStreamSource<StationLog> ds1 = env.addSource(new RichParallelSourceFunction<StationLog>() {
    Boolean flag = true;

    /**
     * 主要方法:启动一个Source,大部分情况下都需要在run方法中实现一个循环产生数据
     * 这里计划1s 产生1条基站数据,由于是并行,当前节点有几个core就会有几条数据
     */
    @Override
    public void run(SourceContext<StationLog> ctx) throws Exception {
        Random random = new Random();
        String[] callTypes = {"fail", "success", "busy", "barring"};

        // 获取当前子任务的索引
        int subtaskIndex = getRuntimeContext().getIndexOfThisSubtask();

        while (flag) {
            String sid = "sid_" + random.nextInt(10);

            // 如果是0号子任务,生成更多数据
            if (subtaskIndex == 0) {
                for (int i = 0; i < 100; i++) {
                    // 数据生成逻辑
                    generateData(ctx, random, sid, callTypes);
                }
            } else {
                // 数据生成逻辑
                generateData(ctx, random, sid, callTypes);
            }
            Thread.sleep(50);

        }

    }

    private void generateData(SourceContext<StationLog> ctx, Random random, String sid, String[] callTypes) {
        String callOut = "1811234" + (random.nextInt(9000) + 1000);
        String callIn = "1915678" + (random.nextInt(9000) + 1000);
        String callType = callTypes[random.nextInt(4)];
        Long callTime = System.currentTimeMillis();
        Long durations = Long.valueOf(random.nextInt(50) + "");
        if (sid.equals("sid_0")) {
            for (int i = 0; i < 100; i++) {
                ctx.collect(new StationLog(sid, callOut, callIn, callType, callTime, durations));

            }
        }
        ctx.collect(new StationLog(sid, callOut, callIn, callType, callTime, durations));
    }

    //当取消对应的Flink任务时被调用
    @Override
    public void cancel() {
        flag = false;
    }
});

//将DataStream 转换成 Table
tableEnv.createTemporaryView("stationlog_tbl", ds1);

//打印表结构
Table table = tableEnv.from("stationlog_tbl");
table.printSchema();

TableResult result = tableEnv.executeSql("" +
        "select " +
        "   sid,count(distinct callType) as total_callType " +
        "from stationlog_tbl " +
        "group by sid");

result.print();
以上代码运行后,可以通过WebUI观察执行情况如下:

当设置拆分distinct聚合参数后,可以看到执行图中多了xxx阶段,并且后续聚合阶段各个task处理数据量相对均衡。只需要在代码中加入如下配置:
... ...
//3.设置拆分distinct聚合
configuration.set("table.optimizer.distinct-agg.split.enabled", "true");
... ...
代码执行后WbeUI信息:


12.7.6 使用Filter修饰符
在某些情况下,用户可能需要从不同维度计算 UV(独立访客)的数量,例如来自 Android 的 UV、iPhone 的 UV、Web 的 UV 和总 UV。很多人会选择 CASE WHEN,例如:
SELECT
 day,
 COUNT(DISTINCT user_id) AS total_uv,
 COUNT(DISTINCT CASE WHEN flag IN ('android', 'iphone') THEN user_id ELSE NULL END) AS app_uv,
 COUNT(DISTINCT CASE WHEN flag IN ('wap', 'other') THEN user_id ELSE NULL END) AS web_uv
FROM T
GROUP BY day
以上SQL中三个查询指标都是针对user_id进行去重统计,每个查询的指标都会维护一个状态实例,导致Flink维护状态过大。在这种情况下,建议使用 FILTER 语法替换 CASE WHEN语法,因为 FILTER 更符合 SQL 标准且能获得更多的性能提升。将上面的示例替换为 FILTER 修饰符,如下所示:
SELECT
 day,
 COUNT(DISTINCT user_id) AS total_uv,
 COUNT(DISTINCT user_id) FILTER (WHERE flag IN ('android', 'iphone')) AS app_uv,
 COUNT(DISTINCT user_id) FILTER (WHERE flag IN ('wap', 'other')) AS web_uv
FROM T
GROUP BY day
Flink SQL 优化器可以识别相同的 distinct key 上的不同过滤器参数。例如,在上面的示例中,三个 COUNT DISTINCT 都在 user_id 一列上,Flink 可以只使用一个共享状态实例,而不是三个状态实例,以减少状态访问和状态大小,在某些工作负载下,可以获得显著的性能提升。
如下代码示例中,使用case when 来统计每个基站中通话时间处于某个时间长度的个数。
//1.使用本地模式
Configuration conf = new Configuration();
//设置WebUI绑定的本地端口
conf.setString(RestOptions.BIND_PORT,"8081");
//使用配置
StreamExecutionEnvironment env = StreamExecutionEnvironment.createLocalEnvironmentWithWebUI(conf);
//开启checkpoint
env.enableCheckpointing(5000);

//创建流处理执行环境
//StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();

//2.创建TableEnv
StreamTableEnvironment tableEnv = StreamTableEnvironment.create(env);

//3.开启minibatch
//通过flink configuration进行参数设置
TableConfig configuration = tableEnv.getConfig();
//开启MiniBatch 优化,默认false
configuration.set("table.exec.mini-batch.enabled", "true");
//设置5秒时间处理缓冲数据,默认0s
configuration.set("table.exec.mini-batch.allow-latency", "5 s");
//设置每个聚合操作可以缓冲的最大记录数,默认-1,开启MiniBatch后必须设置为正值
configuration.set("table.exec.mini-batch.size", "5000");

DataStreamSource<StationLog> ds1 = env.addSource(new RichParallelSourceFunction<StationLog>() {
    Boolean flag = true;

    @Override
    public void run(SourceContext<StationLog> ctx) throws Exception {
        Random random = new Random();
        String[] callTypes = {"fail", "success", "busy", "barring"};
        while (flag) {
            String sid = "sid_" + random.nextInt(10);
            generateData(ctx, random, sid, callTypes);
            Thread.sleep(50);

        }

    }

    private void generateData(SourceContext<StationLog> ctx, Random random, String sid, String[] callTypes) {
        String callOut = "1811234" + (random.nextInt(9000) + 1000);
        String callIn = "1915678" + (random.nextInt(9000) + 1000);
        String callType = callTypes[random.nextInt(4)];
        Long callTime = System.currentTimeMillis();
        Long durations = Long.valueOf(random.nextInt(50) + "");
        ctx.collect(new StationLog(sid, callOut, callIn, callType, callTime, durations));
    }

    //当取消对应的Flink任务时被调用
    @Override
    public void cancel() {
        flag = false;
    }
});

//将DataStream 转换成 Table
tableEnv.createTemporaryView("stationlog_tbl", ds1);

//打印表结构
Table table = tableEnv.from("stationlog_tbl");
table.printSchema();

//使用CaseWhen实现
TableResult result = tableEnv.executeSql("" +
        "SELECT" +
        " sid, " +
        " COUNT(DISTINCT callOut) AS total_sid_cnt, " +
        " COUNT(DISTINCT CASE WHEN duration >= 20 AND duration <40 THEN callOut ELSE NULL END) AS middle_sid_cnt, " +
        " COUNT(DISTINCT CASE WHEN duration >= 40 AND duration <50 THEN callOut ELSE NULL END) AS long_sid_cnt " +
        "FROM stationlog_tbl " +
        "GROUP BY sid ");
result.print();
以上代码执行后可以观察FlinkWebUI 每次checkpoint大小如下:

将代码中的SQL替换成Filter实现方式,如下:
TableResult result2 = tableEnv.executeSql("" +
        "SELECT" +
        " sid, " +
        " COUNT(DISTINCT callOut) AS total_sid_cnt, " +
        " COUNT(DISTINCT callOut) FILTER (WHERE duration>=20 and duration <40) AS middle_sid_cnt, " +
        " COUNT(DISTINCT callOut) FILTER (WHERE duration>=40 and duration <50) AS long_sid_cnt " +
        "FROM stationlog_tbl " +
        "GROUP BY sid ");
可以观察WebUI对应的Checkpoint状态大小,明显较Case When 实现方式管理状态少。
